【AI运镜】不会复杂运镜?先让GPT 6 Astra在Blender里拍一遍
一镜到底最难的不是提示词,而是先把人物、空间和摄影机路线设计清楚。
内容预览
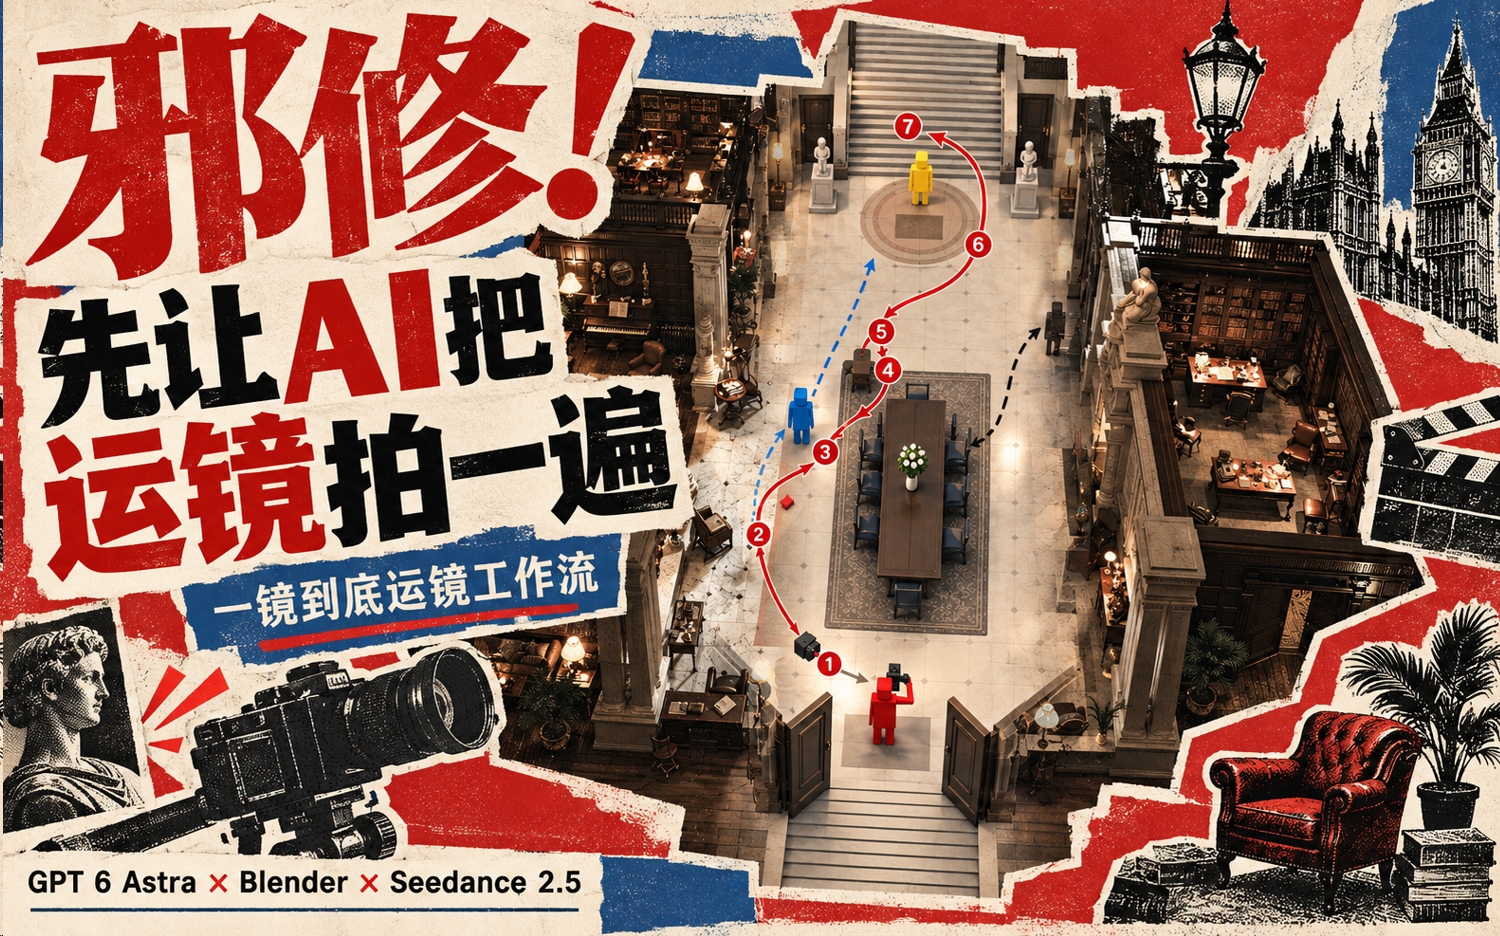
教程内容
一镜到底最难的不是提示词,而是先把人物、空间和摄影机路线设计清楚。
一起来看一下成品:
那么接下来,按照我的思路和步骤,你也可以做出这样的作品,一起来实操吧~
准备工具
seedance2.5 https://jimeng.jianying.com/ai-tool/home/
Midjourney https://www.midjourney.com/explore?tab=top
ChatGPT https://chatgpt.com/
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
如果不想各个网页跳转模型,可以使用flowpix平台,已接入所有热门模型
本次教程的链接如下
https://www.flowpix.club/bj/45039.html?token=50f5908ef7be8fd0997c74cda3d3c8ef
以下是我与ChatGPT的对话记录,粘贴链接至浏览器,即可浏览所有对话历史
https://chatgpt.com/share/6aa7b141-a210-83ea-ab14-e63212201f7a
一、先别急着做运镜,先确定30秒到底发生什么
我这次一开始只有人物,没有剧本,也没有确定场景。
所以第一步不是打开Blender,而是把现有角色全部交给AI,让它先根据人物身份帮我推导适合一镜到底的情节。
我使用的提示词是:
我想做一个一镜到底运镜的视频,主要方法是使用GPT 6 Astra去制作Blender粗模运镜,然后使用Seedance 2.5去视频参考生成视频。这是我现有的模特,图1是女主,图2是公爵,图4是记者,图3是管家。我需要先做一个较大场景俯视场景运镜图,可以是方块的,有一些颜色区分,需要有一条摄像机运镜路线。你先帮我想几个适合这些人物的情节,让我筛选,保证最终视频能够控制在30秒以内。剧情尽量依靠人物动作、走位和镜头信息推进,不要依赖大量对白。
直接去询问ChatGPT
AI会根据人物身份给出几种剧情方向。
AI给我的几个剧本
这里我第一次拿到的剧本其实并不满意。
问题不在于剧情完全不能用,而是开头太正常了。
如果一个30秒视频前几秒只是人物进入大厅、管家走出来、摄影机开始跟拍,那么即使后面的调度很复杂,观众也未必愿意继续看。
所以我额外增加了一个要求:
开场从女主的腿开始拍。
直接让ChatGPT修改
最终我把开头设计成:
女主向前走,一封红色信件突然滑到她脚边,她直接一脚踩住。
这件事发生以后,观众马上会产生一个问题:
她为什么要踩住这封信?
后面的剧情再继续解释,这封信来自管家、女主偷偷把它拿走、最终交给公爵,而记者则在远处拍下这一切。
这就是我认为AI写剧本时很重要的一步。
AI先帮你解决结构,但钩子不一定要全部交给AI决定。
你完全可以先选择一个大方向,再自己加入一个更有视觉吸引力的动作。
二、别看到剧本就开做,先验证30秒能不能真的拍完
AI写出的“30秒剧本”,不代表真的可以在30秒里完成。
因为文字里的“女主走过去”“摄影机绕到侧面”“管家停下来寻找”,读起来只有一句话,但真正变成视频以后,每个动作都需要时间。
尤其是一镜到底。
它不能依靠剪辑直接从A点跳到B点。
人物走过去需要时间,摄影机移动过去也需要时间。
所以选定剧情以后,我会再单独问AI一次(假如大家想做更长的剧本,可以不做限制):
请重新检查这个一镜到底剧本是否真的可以在30秒以内完成。不要只按照文字长度判断,请按照真实人物行走速度、人物动作耗时、动作之间的停顿、摄影机移动距离、摄影机环绕和升降机位所需要的时间进行